レポート: 情報発信部会・藤本(NEC)
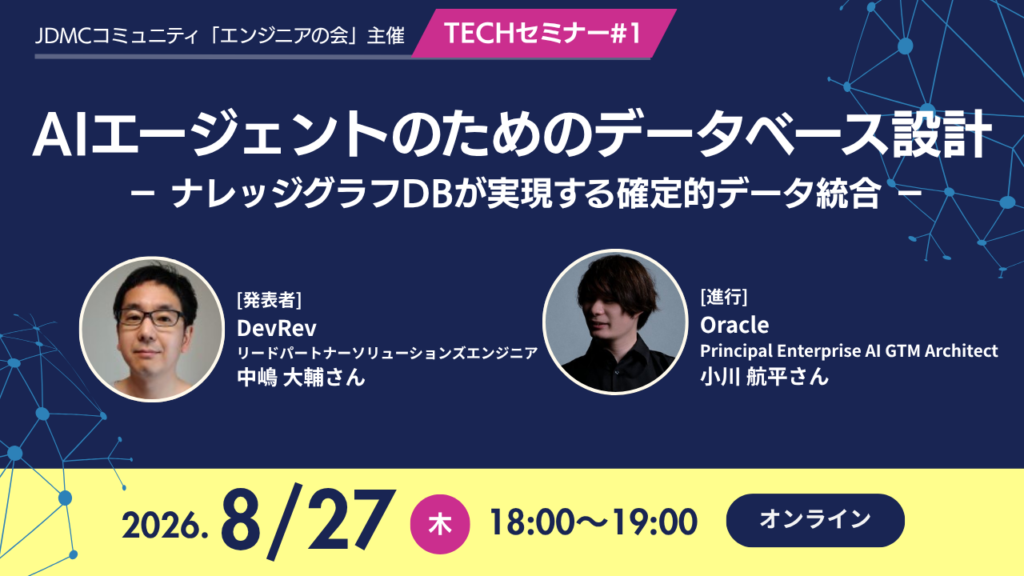
2026年8月27日、エンジニアの会主催のオンラインTECHセミナー「AIエージェントのためのデータベース設計 ― ナレッジグラフDBが実現する確定的データ統合 ―」が開催された。JDMC会員企業である日本オラクルの小川航平氏の進行のもと、DevRev合同会社の中嶋大輔氏が登壇。AIエージェントを有効に活用するために、データをどのように設計・構造化すべきかについて講演した。DevRevは、AIによるデータ活用を支援するSaaSプラットフォームを提供する米国発のスタートアップ企業。本講演では、中嶋氏の実務経験や知見を交えながら、AIエージェント時代に求められるデータ設計について、実践的な視点から解説された。
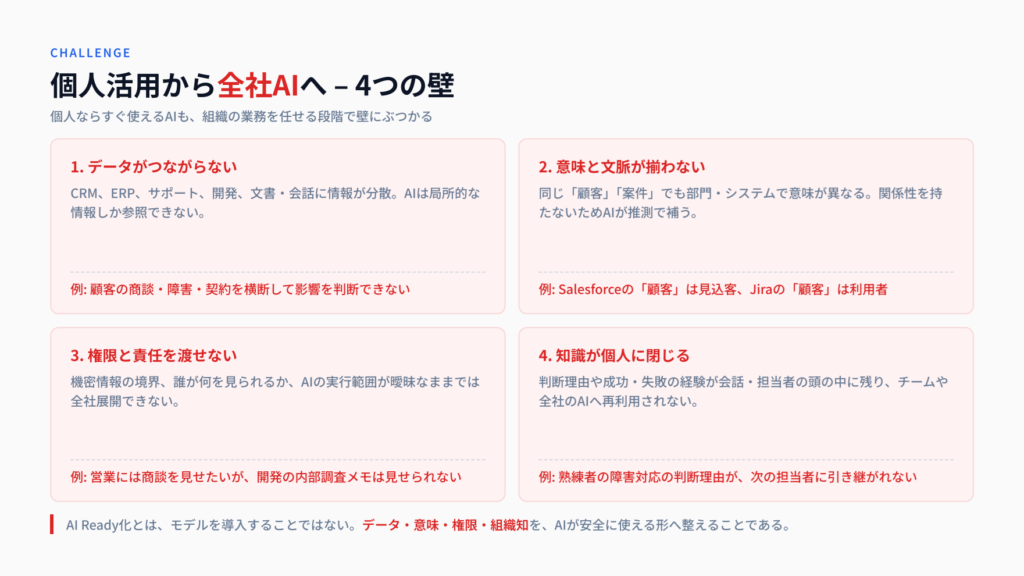
「個人のAI活用」と「全社のAI活用」の間にある4つの壁
中嶋氏はまず、個人によるAI活用と全社的なAI活用の間には大きな隔たりがあり、その背景には4つの壁が存在すると説明した。その壁とは、「データがつながらない」「意味と文脈がそろわない」「権限と責任を渡せない」「知識が個人に閉じている」の4つである。
そのうえで、企業に求められるAI Ready化とは単純にAIモデルを導入することではなく、データ・意味・権限・組織知をAIが安全かつ効果的に活用できる形へ整備することであると述べた。
ナレッジグラフDBとは何か:関係性をデータ構造として持つ
そして、この壁を乗り越える手段として提案されたのがナレッジグラフDBだ。ナレッジグラフDBは、プロパティ(属性)を持つノード(エンティティ)をエッジと呼ばれる関係性で繋ぐネットワーク構造のデータベースである。従来の検索手法では複数のテーブルを結合したり複雑な検索処理を行ったりする必要があるが、ナレッジグラフDBでは関係性そのものを構造として保持しているため、エッジをたどることで効率的に情報へ到達できる。
また、中嶋氏はナレッジグラフDBの特徴として、同一のクエリに対して同じ結果が返る性質を挙げた。生成AIにおいては再現性や説明可能性が重要視される場面も多く、確定的な検索結果を得られることは大きな利点となる。さらに、新しいシステムやデータソースを追加する際も、大規模なスキーマ変更を必要とせず、ノードとエッジを追加するだけで柔軟に統合を進められる。加えて、ナレッジグラフDBは検索精度やトークン効率に優れており、システム規模が拡大した際のコスト面もほぼ横ばいで推移するという。 この検索精度の優位性はDevRevが公開しているオープンベンチマーク「Enterprise-Bench」でも示されている。具体的には、DevRevが独自開発したAIエージェント「DevRev Computer」が複数システムにまたがる業務検索タスクで平均スコア0.94以上(満点1.0)を記録している。同条件で実施したClaude Codeのスコアが0.6程度であったことと比較すると、エージェントのデータ設計の差が検索精度に大きく直結することが示されている(参考:github.com/devrev/enterprise-bench)。
構築の鍵はオントロジー設計と「Memory」の活用
続いて、ナレッジグラフDBを構築するうえで重要な考え方としてオントロジー設計が紹介された。全社で利用する共通ノード群をコアオントロジーとして定義し、それを中心に各部門や業務領域がローカルな拡張を行う設計により、全社共通のデータ活用基盤を維持しながら各領域の独自性にも対応できる。
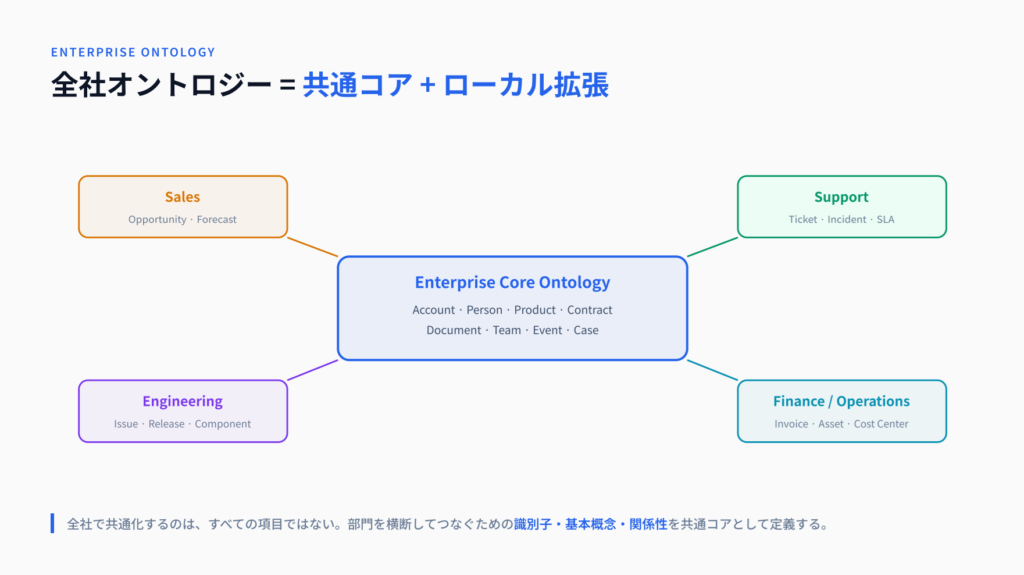
また、顧客や商談、障害、手順、対応履歴と、その関係性や時系列、判断理由などを再利用可能な形で保持した業務記憶、いわゆる「Memory」の考えも重要になってくるという。全社、チーム、個人と各レイヤーでこのMemoryを使い分けることで、AIが次の判断と行動に活かすことが可能となる。単にデータを保存するだけでなく、背景情報や判断理由まで含めて構造化することで、知識を個人に閉じ込めることなく組織全体で共有できるようになるという。中嶋氏によると、業務イベントが発生するたびにナレッジグラフは確定的に成長していくとのことだ。業務上の仕事一つひとつが発生することで、定義済みノードと関係性が積み上がっていくのだ。
DWH/LakehouseとナレッジグラフDBは競合しない
一方で、中嶋氏はDWHやLakehouseとの違いについても言及した。ナレッジグラフDBは関係性をたどる検索や意味的な探索に強みを持つ一方で、DWHやLakehouseは大量データの蓄積や集計処理、機械学習用途に強みを持つ。ナレッジグラフDBは大量かつ高頻度な更新処理を伴うトランザクションシステムには必ずしも向いておらず、その領域はDWHやLakehouseが担うべきだと説明した。
つまり、両者は競合する技術ではなく補完関係にあるということだ。講演では、DWH/Lakehouseを外部記憶装置、ナレッジグラフDBをメインメモリ、LLMをCPUとして捉え、それぞれを一つのパスで連携させることで効率的なAI活用基盤を構築できるとのことだった。
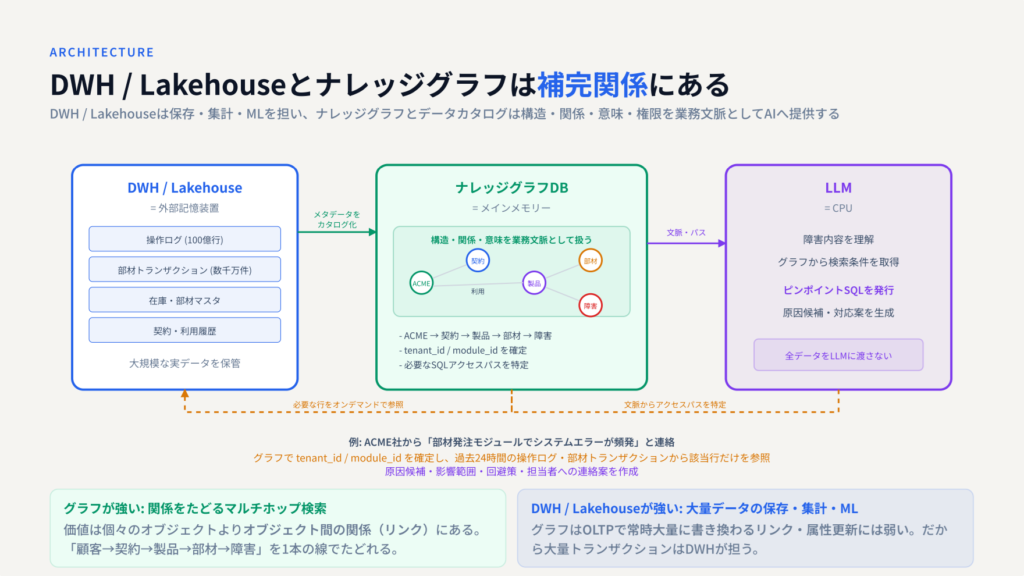
さらにここで中嶋氏が強調したのが、「LLMに確定的な業務事実を任せない」という設計原則だ。LLMは自然言語の理解・説明・提案に強みを持つが、名寄せや関係性、権限といった業務事実は再現性と監査性のあるルールで確定させるべきだという。同じ入力でも表記ゆれや文脈解釈によって関係性が変わったり、一度AIが誤った関係性を結ぶとその誤りを前提に回答が続いてしまったりするリスクがある。修正や監査の根拠を説明できなくなることは、信頼性の観点から致命的だ。だからこそ、名寄せや関係性・権限といった業務事実はLLMに委ねず、ナレッジグラフDB側で確定させるべきだという考え方が重要になる。
その点、DevRevのナレッジグラフDBはノードとエッジを一意に決定し、関係を宣言的に確定させることでLLMに推測させることなく事実を判断させている。確定的なデータ統合があるからこそ、AIは根拠あるアクションが可能になる。これがAI Ready化を進めるうえでの重要な設計原則だという。
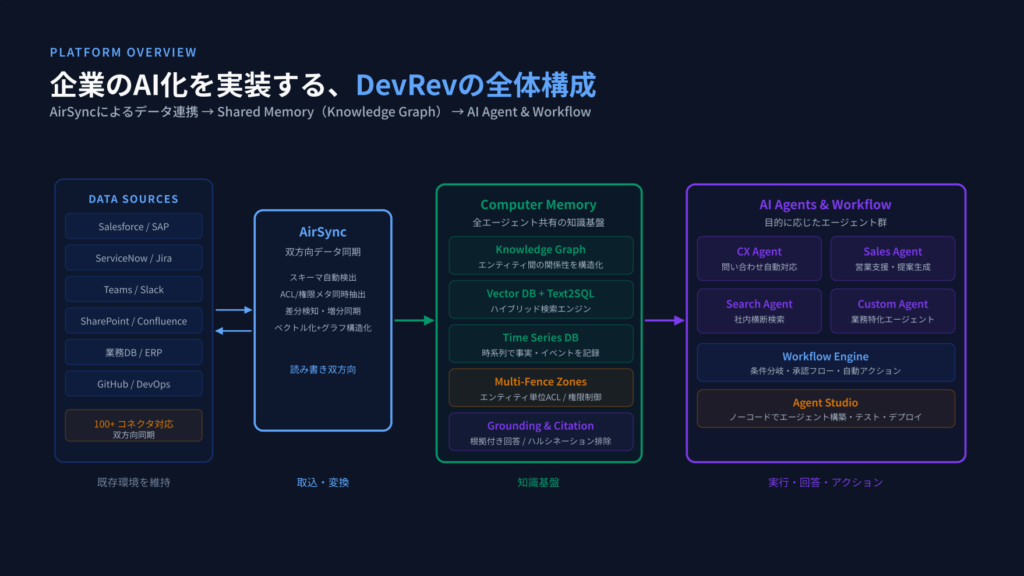
DevRevが解決する導入ハードルと5つのハイブリッドエンジン
通常のナレッジグラフDBには設計や運用面でいくつか課題があるという。そこで、DevRevの製品ではその課題を実装時に解決し、導入初日からすぐに使える形にしているという。さらに、DevRevで提供されるナレッジグラフDBは、ナレッジグラフの他、ベクトル検索を含む計5つのエンジンを組み込んだハイブリッド設計で精度を高めている。SQLでデータを絞り込んだうえでエッジで繋いでグラフ化し、そこにベクトル検索をかけて必要な要素だけをピックアップすることも可能だ。さらに、自然言語で問いを投げかけると、バックエンドでは監査情報が発行されており、回答根拠をクエリで追跡できる。なぜその答えになったかをいつでも検証できる仕組みが整っている。
実務者たちの疑問が集中したQ&A
質疑の時間では、グラフDBの必要性や既存技術との違いに踏み込んだ問いが多数寄せられ、中嶋氏が一つひとつ丁寧に回答した。印象的なやり取りをいくつか紹介する。
Q:RDBを使ってきた自分としては、そもそもグラフにする必要性がわかっていません。
A:マルチホップの検索ができるようになる点が大きい。もともと違うデータを一部グラフにして、関連性をつけてAIに渡せることが必要性への答えになると思う。具体的には2つの強みがある。1つ目は「関係の種類を後から足せる」こと。RDBで多対多の関係を表現するには中間テーブルが必須で、関係の種類が増えるたびにスキーマ変更が必要になるが、グラフはエッジを1本追加するだけで済む。2つ目は「関係そのものが意味と属性を持つデータになる」こと。RDBの外部キーは「つながっている」ことしか表現できないが、グラフのエッジは関係の種類・方向・属性を持てる。
Q:大規模案件でグラフ構造が巨大化・複雑化した場合でも、MCPよりグラフ構造の利用が優位になりますか。
A:まず前提として、グラフとMCPは対立するものではなく役割が異なる。グラフはデータの持ち方・つなぎ方、MCPはAIが外部システムにアクセスするプロトコルだ。現在の調査では、巨大になればなるほどデータ取得の面でグラフ構造が優位になることがわかっている。MCPでその都度データを取りに行く方式だと、多段の関係を辿るたびに外部システムへのAPI呼び出しが積み重なり、ホップ数に比例してレイテンシが増大する。また、取得した中間データをAIのコンテキストに何度も載せ直すため、推論そのものが重くなり、トークン消費と待ち時間が増大する。複雑化するほどこの往復のコストは指数的に効いてくる。一方グラフは関係があらかじめエッジとして統合済みのため、多段の探索を1回で辿れる。大規模・多段になるほどこの差は開く。
Q:後輩に「SQLでもできますよね」と言われて返せていません。グラフ構造の優位点を教えてください。
A:SQLでも管理は可能だが、大量の構造化・非構造化データをテーブルで管理することになり比較的大変になる。グラフ構造はRDBと違って主キーを持たず、どのノードをルートにたどるかを柔軟に設計できる。また、データソースをホッピングしながら外のデータとうまく連携してアクションを残せる点が大きな違いだ。
AI活用の成功のカギはデータ設計と組織知の管理にある
昨今ではAI活用やデータ活用の重要性が広く認識されている一方で、データの分断や知識の属人化に悩む企業は少なくない。本セミナーは、そのような課題を改めて整理し、ナレッジグラフDBという具体的な解決策を提示する内容であった。AI活用の成否はモデルだけではなく、データ構造や組織知の管理にも大きく依存することを再認識する機会となった。
なお、本セミナーはTECHセミナーの第1回として開催された。参加者は160名を超え、質疑は時間内にすべて答えきれないほどの盛況ぶりであった。データ活用・AI活用への社会的関心の高さを示す結果であり、第2回以降のセミナーにも大きな注目が集まっている。
<投影資料>
https://speakerdeck.com/daiz21/ai-ejento-no-tame-no-deta-sekkei
執筆者プロフィール
(ふじもと)2025年4月にNECへ新卒入社し、現在2年目。主にお客様の業務課題を解決するため、Oracle製品・サービスの導入支援に携わっている。昨年入社1年目で、Oracle Master Goldを取得。